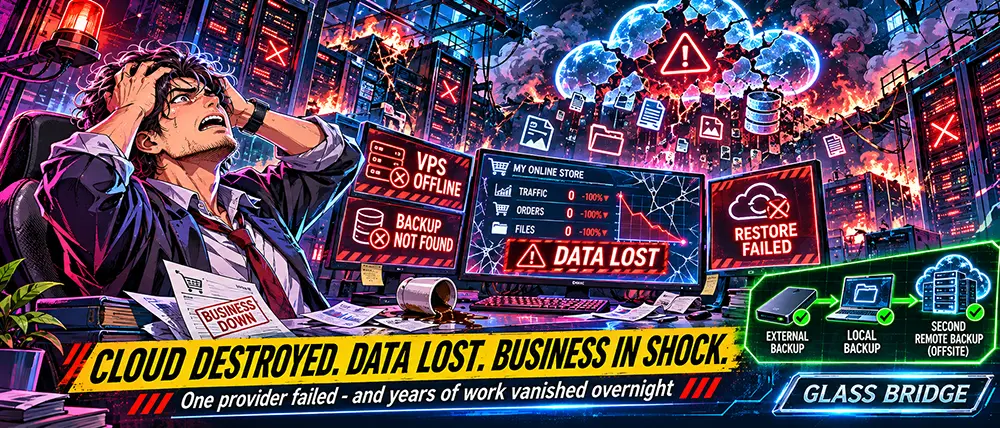
Suite de l'enquête « 25 minutes avant la destruction : comment le piratage de Beget a fait s'effondrer son infrastructure cloud ».
7 novembre 2026 | Pont de verre | Cybersécurité
Imaginez que vous passiez cinq ans à bâtir votre entreprise.
Vous créez une boutique en ligne, développez votre propre plateforme, rassemblez une clientèle. La nuit, vous corrigez des bugs, payez des développeurs, achetez des serveurs et investissez dans la publicité.
Sur l'écran de votre tableau de bord, un message rassurant s'affiche quotidiennement : BACKUP COMPLETED.
Puis, un beau matin, au lieu de voir votre projet fonctionner, vous découvrez le néant.
Le serveur a été anéanti. La base de données est inaccessible. Le panneau de contrôle ne s'ouvre plus. Et la sauvegarde a elle aussi disparu.
Vous n'avez pas oublié votre mot de passe. Vous n'avez pas manqué un paiement. Vous n'avez enfreint aucune condition d'utilisation.
C'est simplement que l'infrastructure de l'entreprise à laquelle vous avez confié des années de votre vie a été la cible d'un commando malveillant.
Et désormais, l'avenir de votre entreprise dépend de la capacité d'ingénieurs tiers à récupérer des fragments de données rescapés.
Ceci n'est pas le scénario d'un thriller de science-fiction.
Ce sont les conséquences bien réelles de la cyberattaque menée contre l'hébergeur russe Beget.
1. De vingt-cinq minutes d'attaque à la perte de données clients
Dans notre première enquête sur l'attaque de Beget, nous avons décortiqué la chronologie des événements survenus dans la nuit du 2 novembre 2026.
Selon la chronologie officielle communiquée par Beget, l'intrusion présumée dans l'infrastructure de gestion a débuté vers 02h00, heure de Moscou.
À 02h30, les assaillants ont exécuté un logiciel malveillant conçu pour supprimer les données.
À 02h40, les équipes techniques ont détecté des signes d'accès non autorisé.
À 02h55, les serveurs ont été déconnectés du réseau afin d'endiguer la propagation de l'attaque.
Vingt-cinq minutes se sont écoulées entre le lancement du programme destructeur et la mise hors réseau des serveurs.
Mais la véritable ampleur de la catastrophe ne s'est révélée que plus tard.
Le 6 novembre, l'agence Interfax a publié une nouvelle estimation des pertes de Beget : d'après les prévisions de l'hébergeur, les sauvegardes de fichiers VPS ne seront disponibles que pour environ la moitié des utilisateurs.
À cette date, l'entreprise était parvenue à rétablir plus de 60 % de son hébergement virtuel et 40 % des serveurs dédiés placés sous son administration.
Quant à l'infrastructure cloud, il a fallu la reconstruire de zéro.
Le média RBC a également signalé des altérations touchant les données internes du fournisseur : chez certains utilisateurs, les associations logiques entre comptes et services s'étaient volatilisées.
Cela signifie que même lorsqu'un archive a survécu, il n'est pas toujours possible de la restituer immédiatement à son propriétaire.
Il faut d'abord la localiser, l'identifier correctement et la relier au bon client.
Les cybercriminels ne se sont pas contentés de frapper les serveurs. C'est le système de restauration lui-même qui a été compromis.
2. Pourquoi les sauvegardes n'ont pas sauvé tout le monde
De nombreux propriétaires de sites web partagent une certitude : si un hébergeur propose des sauvegardes, alors leurs informations sont en sécurité.
Pourtant, il existe un gouffre entre posséder une archive et s'assurer de son indépendance.
Imaginez un site industriel doté de trois groupes électrogènes de secours.
Le premier est installé dans l'atelier principal. Le second dans le bâtiment voisin. Le troisième à l'extérieur du site principal.
Le système semble robuste.
Mais ces trois générateurs sont raccordés au même automate de commande. Et une seule défaillance de cet automate empêche simultanément le démarrage de toutes les unités.
La redondance est bien là.
L'indépendance, elle, est absente.
Dans une infrastructure serveur, un problème similaire surgit lorsque les machines virtuelles de production, les espaces de stockage, les instantanés (snapshots) et les solutions de sauvegarde dépendent d'un unique plan de contrôle.
C'est ce qu'on appelle le Control Plane (le plan de contrôle).
C'est par son intermédiaire que l'on déploie des serveurs virtuels, que l'on connecte des disques, que l'on modifie les paramètres réseau, que l'on gère et supprime les ressources.
Si un attaquant obtient des privilèges suffisants, il n'a pas besoin de pirater chaque serveur individuellement.
Il dispose du pouvoir d'agir sur l'ensemble des ressources de manière centralisée.
Beget a confirmé sur sa chaîne officielle Telegram que des assaillants avaient réussi à s'introduire dans le circuit de pilotage et à exécuter des scripts de purge.
Cependant, les commandes exactes, la vulnérabilité initiale et le mécanisme précis de destruction n'ont pas été divulgués publiquement.
Il est donc impossible d'affirmer avec certitude quel outil précis a été employé par les assaillants.
Mais une conclusion d'ordre architectural s'impose d'ores et déjà :
Trois sauvegardes ne servent à rien face à un seul identifiant volé, dès lors que cet identifiant possède les droits d'effacer les trois.
3. La perte la plus coûteuse : le temps, pas le serveur
Un serveur physique se remplace.
Un nouveau VPS se commande en quelques minutes.
Un système d'exploitation se réinstalle.
Mais comment remplacer une base de données clients accumulée au fil de cinq années ? Comment reconstituer l'historique des commandes, les contrats signés, les photographies, les contenus originaux, les documents et les fruits du travail d'équipe ?
Ce coup de massue frappe de plein fouet les petites structures.
Une grande entreprise dispose généralement de sites secondaires, d'équipes d'infrastructure dédiées et de plans de reprise d'activité (PRA) rodés.
À l'inverse, une petite entreprise s'appuie souvent sur un seul serveur, une unique base de données et un dirigeant qui cumule les casquettes de directeur, de responsable marketing et d'administrateur système.
C'est pourquoi l'impact varie du tout au tout.
Telle entreprise cliente de Beget parviendra à migrer vers un autre fournisseur et à relancer son activité à partir d'une archive indépendante.
Telle autre devra recoller les morceaux de son projet à la petite semaine.
Tandis qu'une troisième réalisera que ses données ont définitivement disparu.
L'exemple du service d'autopartage BelkaCar est éloquent. Comme l'a indiqué RBC, la panne de l'infrastructure de Beget a perturbé l'activité du service, avant que l'entreprise ne rétablisse l'accès en basculant sur un prestataire alternatif.
La différence est fondamentale.
La première entreprise est prisonnière du retour en ligne de son ancien hébergeur. La seconde est capable de poursuivre son activité sans lui.
C'est cela, en pratique, la souveraineté numérique.
4. L'erreur d'ingénierie cardinale : mettre tous ses œufs dans le même panier
Le schéma classique d'un petit projet web ressemble à ceci :
- Le site web est hébergé chez un seul fournisseur.
- La base de données y est stockée au même endroit.
- Les e-mails et les DNS transitent par la même infrastructure.
- Les sauvegardes sont générées depuis le même panneau de contrôle.
- Les accès administratifs se concentrent dans un unique compte utilisateur.
Tant que tout fonctionne, cette architecture paraît confortable.
Une seule interface. Une seule facture. Un seul support technique.
Mais ce confort se mue en dépendance.
En cas d'incident majeur, le propriétaire perd simultanément son application, ses données, le contrôle de son nom de domaine et l'accès à ses archives.
Et basculer vers un autre serveur du même fournisseur ne résout rien si l'ensemble des ressources obéit au même système de gestion centralisé.
Une véritable tolérance aux pannes commence par la cloison des serveurs, mais aussi par celle des privilèges.
C'est la philosophie du Zero Trust (confiance zéro) : un accès ne doit jamais être considéré comme sûr au seul motif qu'il se trouve à l'intérieur de l'infrastructure ou qu'il appartient à un administrateur.
Chaque composant ne doit se voir attribuer que les stricts droits nécessaires à son fonctionnement.
Cette exigence est particulièrement critique pour les sauvegardes.
Un serveur de production peut générer de nouvelles archives, mais il ne doit en aucun cas disposer du droit illimité d'en effacer l'historique.
5. L'architecture de survie : trois cercles indépendants
Pour encaisser la destruction totale de son hébergement principal, tout projet a besoin d'un système de restauration affranchi de son panneau de contrôle habituel.
Cercle n° 1 : L'infrastructure de production
C'est ici que résident le site en service, l'API, PostgreSQL, les fichiers utilisateurs, les applications et les différents services.
Cette plateforme absorbe la charge quotidienne.
Elle ne doit en aucun cas constituer l'unique lieu de stockage des données critiques.
Cercle n° 2 : L'archive indépendante
Les sauvegardes sont transmises à un prestataire tiers doté d'identifiants de connexion rigoureusement distincts.
Le stockage objet compatible avec la fonction S3 Object Lock (verrouillage d'objets S3) constitue par exemple une option idéale.
En mode Compliance (conformité), une version protégée d'un objet ne peut être ni supprimée ni écrasée avant l'expiration de la période de rétention définie, pas même par le propriétaire du compte.
Ces mécanismes sont détaillés dans la documentation officielle d'Amazon Web Services.
Toutefois, cette protection s'applique à des versions d'objets spécifiques et requiert un paramétrage rigoureux. Elle ne remplace ni le chiffrement ni la vérification des procédures de restauration.
Cercle n° 3 : La copie autonome et le plan de relance
Ce troisième niveau correspond à un ordinateur local, un support de stockage externe ou une plateforme de secours totalement indépendante.
On doit y retrouver non seulement les fichiers du site, mais aussi l'ensemble des éléments indispensables à la reconstruction :
- des sauvegardes de bases de données validées ;
- les configurations des serveurs et des applications ;
- les fichiers et médias des utilisateurs ;
- la documentation de déploiement ;
- les clés de chiffrement et de restauration sécurisées ;
- des consignes de démarrage des services testées et approuvées.
Les secrets sensibles doivent être conservés à part, sous forme chiffrée, avec un accès redondant.
Le test ultime est d'une simplicité redoutable.
Si votre hébergeur principal venait à disparaître entièrement dès demain, seriez-vous en mesure de relancer votre projet en vous appuyant uniquement sur vos copies indépendantes ?
Si la réponse est incertaine, c'est que votre architecture de restauration n'est pas au point.
6. Pourquoi une bonne sauvegarde s'avère parfois inutile
Il existe une autre illusion redoutable.
Un administrateur système aperçoit le message BACKUP SUCCESS et considère sa mission accomplie.
Or, la création réussie d'une archive ne garantit en rien la réussite de sa restauration.
À titre d'exemple, une base de données PostgreSQL gère en permanence des flux de transactions en évolution constante.
Une simple copie brute des fichiers d'une base active, réalisée sans respecter les protocoles requis, ne garantit pas l'obtention d'un instantané cohérent.
Pour pouvoir être restaurées, les données exigent des dumps logiques propres ou des sauvegardes physiques assorties des journaux de transactions (WAL) indispensables.
De même, une application conteneurisée peut dépendre d'une multitude de paramètres externes : variables d'environnement, clés cryptographiques, volumes de données, configurations de proxy et versions logicielles.
C'est pourquoi la procédure de restauration doit impérativement être mise à l'épreuve sur un environnement neutre.
Et non le jour de la crise, lorsqu'il est déjà trop tard.
Bien en amont.
Les spécialistes utilisent deux métriques fondamentales :
Le RPO (Recovery Point Objective) — le volume de données qu'il est tolérable de perdre en cas d'incident.
Le RTO (Recovery Time Objective) — le délai maximal toléré pour rétablir le service.
Si les bases ne sont sauvegardées qu'une fois par nuit, l'entreprise risque de perdre près de 24 heures d'activité récente.
Si une archive existe mais que son redéploiement prend trois jours entiers, l'activité restera paralysée pendant trois jours.
Ces deux indicateurs doivent impérativement être en phase avec la réalité économique du projet.
7. Que doivent faire les propriétaires de sites dès maintenant
Il n'est pas question de louer immédiatement plusieurs centres de données aux quatre coins du globe.
Il s'agit d'éliminer le point unique de défaillance catastrophique.
Premièrement. Vérifiez qui détient, physiquement et administrativement, le stockage de vos sauvegardes.
Deuxièmement. Générez une copie indépendante de vos données critiques chez un autre prestataire ou sur votre propre matériel.
Troisièmement. Dissociez les droits de création et de suppression des archives. Activez le versioning (gestion des versions) et le stockage immutabilité chaque fois que c'est possible.
Quatrièmement. Préparez une solution de secours pour la gestion de vos DNS. L'enregistrement du domaine, la gestion des serveurs DNS et l'hébergement du site sont trois prestations distinctes.
Cinquièmement. Réalisez un exercice de restauration à blanc : déployez votre projet sur un serveur vierge et assurez-vous que la base de données, les fichiers et l'application s'exécutent correctement.
Sixièmement. Conservez une archive chiffrée séparée regroupant vos configurations critiques, ainsi qu'un accès sécurisé à vos clés et à vos dispositifs d'authentification multifacteur (MFA).
Septièmement. Testez vos restaurations à intervalles réguliers, en particulier après chaque modification d'envergure de votre infrastructure.
Et retenez la règle absolue : aucune sauvegarde ne doit être considérée comme unique, quand bien même elle porterait l'étiquette de « sauvegarde ».
8. Quel avenir pour Beget et ses clients ?
Au 7 novembre, les opérations de rétablissement se poursuivent.
L'entreprise communique publiquement sur la neutralisation des suites de l'attaque et sur la reconstruction de son infrastructure cloud. Il est possible de suivre l'évolution de la situation via le canal Telegram officiel de Beget.
Il existe toutefois une nuance de taille entre le rétablissement de la plateforme de l'hébergeur et la récupération des données de chaque client touché.
L'entreprise peut relancer ses capacités serveurs.
Elle peut redonner accès au panneau de gestion.
Elle peut rétablir l'accès aux noms de domaine et aux sites web.
Cependant, cela ne garantit pas la restitution automatique de l'ensemble des données utilisateurs pulvérisées.
C'est précisément la raison pour laquelle Interfax et RBC soulignent explicitement le problème de la disponibilité des archives de fichiers VPS.
Pour autant, il est encore prématuré d'évoquer un risque de faillite pour Beget. L'ampleur du sinistre est avérée, mais l'horizon financier de l'entreprise reste à écrire.
Pour ses clients, une interrogation autrement plus cruciale demeure : quelles données exactes parviendra-t-on à sauver et combien de temps faudra-t-il pour redresser leur activité ?
9. Conclusion : votre entreprise ne doit pas mourir en même temps que votre hébergeur
La cyberattaque visant Beget fait office d'électrochoc pour le marché numérique russe.
Un fournisseur peut aligner une infrastructure gigantesque, une armada d'ingénieurs et des années de réputation.
Il suffit pourtant d'une seule compromission critique de son système de pilotage pour que les ondes de choc ravagent une myriade d'entreprises indépendantes et de projets personnels.
Pour les petites structures, le scénario vire au cauchemar.
Derrière un serveur détruit ne se cache pas un simple ensemble abstrait de disques virtuels.
On y trouve souvent des années de nuits blanches, des économies familiales, des crédits bancaires, le labeur des salariés, la confiance des clients et l'avenir d'un entrepreneur.
Voilà pourquoi la mise en place de sauvegardes indépendantes ne relève pas du caprice technique d'un administrateur tatillon.
C'est le bouclier qui protège le fruit du labeur humain.
Vous pouvez louer un serveur.
Vous pouvez louer un cloud.
Vous pouvez confier la maintenance matérielle à un prestataire.
Mais vous ne devez jamais octroyer à une seule et même entreprise le pouvoir exclusif de préserver ou d'anéantir tout ce que vous avez bâti.
Un hébergeur doit pouvoir être remplacé. Vos données, non.
Articles connexes et sources primaires
Pont de verre : 25 minutes avant la destruction — première partie de l'enquête
Beget Official — communiqués officiels sur la cyberattaque et la reprise des services
Interfax — évaluation des pertes concernant les sauvegardes VPS