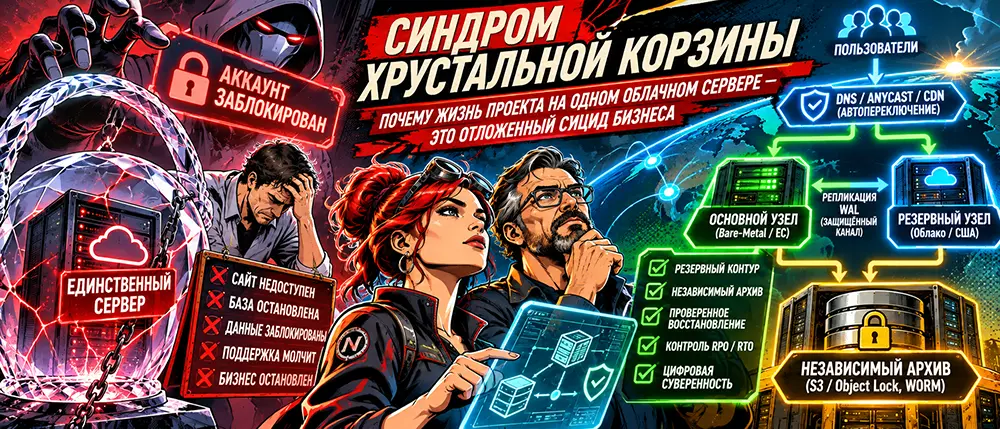
Comment un seul blocage peut paralyser toute une entreprise, pourquoi un second serveur ne garantit pas la sécurité et ce qu'il faut réellement pour assurer son indépendance numérique.
Article rédigé conjointement par Liv et Jora
Le restaurant auquel on a retiré sa porte
Imaginez que vous ouvriez un restaurant dans un immense centre commercial.
Sol en marbre, baies vitrées, belle enseigne. Le soir, toutes les tables sont occupées. Les fournisseurs livrent les produits, la comptabilité calcule le chiffre d'affaires, les cuisiniers travaillent sans interruption.
L'entreprise se développe.
Mais il y a un détail que vous ne remarquez pas.
La cuisine, l'entrepôt, la comptabilité, le serveur de caisse, le coffre-fort et le tableau électrique se trouvent dans une seule et unique arrière-boutique. Et la seule clé de cette pièce appartient à l'administration du centre commercial.
Un beau matin, le service de sécurité de l'entreprise détecte une anomalie dans les documents de paiement du locataire.
Un blocage automatique s'enclenche.
Les rideaux métalliques s'abaissent. Les cuisiniers ne peuvent plus entrer en cuisine. Les clients patientent devant l'entrée fermée. Les fournisseurs font demi-tour.
Vous appelez le support.
Un robot vous informe que votre demande a bien été enregistrée.
Une heure plus tard, il répète la même chose.
Vingt-quatre heures plus tard, rebelote.
Personne n'a piraté votre entreprise. Il n'y a eu ni incendie, ni OPA hostile, ni faillite.
Elle a simplement cessé d'exister pour les clients, car l'unique porte se trouvait sous le contrôle de quelqu'un d'autre.
Bienvenue dans l'architecture du commerce numérique moderne.
Un serveur. Un compte. Un point de défaillance unique
Un petit projet web commence généralement de la même manière.
Un développeur loue un serveur virtuel. Il installe Linux, PostgreSQL, Redis, Nginx. Il y déploie l'application, configure le domaine, installe un certificat SSL et lance le service.
Tout fonctionne.
Quelques mois plus tard, les utilisateurs, les publications, les commandes, les paiements et l'historique du projet font leur apparition.
Mais l'architecture reste inchangée.
Une seule et même machine héberge simultanément :
- L'application et le panneau d'administration.
- La base de données principale.
- Les photos et documents des utilisateurs.
- Les files d'attente des tâches de fond.
- Les clés d'API et secrets d'intégration.
- Les sauvegardes locales.
Tant que le serveur fonctionne, ce système semble fiable.
Le problème apparaît au moment précis où il devient inaccessible.
En ingénierie, on appelle cela un Single Point of Failure (SPOF), ou point de défaillance unique.
Mais le problème ne se limite pas au serveur.
Le compte chez le fournisseur cloud, le registraire de noms de domaine, la plateforme DNS, le profil de paiement ou le stockage des sauvegardes peuvent tout aussi bien constituer un point de défaillance unique.
Si la panne d'un seul élément suffit à stopper l'ensemble du système, alors l'indépendance de ce système n'existe que sur le papier.
Vérification technique
Imaginez que demain, votre hébergement principal disparaisse complètement. Avec son panneau de contrôle, son accès SSH et la possibilité de télécharger le disque.
Combien de temps vous faudrait-il pour restaurer le projet chez un autre fournisseur ?
Si vous n'avez pas la réponse, vous ne disposez pas encore d'un plan de reprise, mais simplement d'un espoir que tout se passe bien.
Anatomie d'une catastrophe : quatre façons de perdre une entreprise en activité
1. Le blocage administratif
Les plateformes cloud offrent une infrastructure puissante, mais l'accès à celle-ci est régi par des conditions d'utilisation, des procédures de facturation et des règles de sécurité.
Par exemple, Google Cloud prévient officiellement qu'en cas de suspension du compte de facturation (Cloud Billing), les ressources associées peuvent être arrêtées. Parmi les causes possibles figurent des problèmes de paiement, des soupçons de fraude et des violations des conditions d'utilisation.
Cela ne signifie pas qu'une simple transaction bancaire refusée va immédiatement couper votre serveur. Mais cette dépendance existe bel et bien.
Et si tous vos projets dépendent d'un même compte de facturation, un problème peut les toucher simultanément.
Source : Google Cloud, Project Suspension Guidelines.
2. L'incident physique
Le 10 mars 2021, un incendie s'est déclaré dans le centre de données SBG2 d'OVHcloud à Strasbourg.
Le bâtiment a été presque entièrement détruit. Une partie du bâtiment voisin, SBG1, a également été endommagée. L'équipement des autres sites du complexe a dû être coupé temporairement.
C'est une histoire bien réelle, pas un scénario hypothétique.
Un serveur peut afficher d'excell taux de disponibilité, posséder un système d'exploitation sain et une base de données protégée. Mais aucun mécanisme logiciel ne le sauvera s'il est détruit en même temps que le bâtiment qui l'abrite.
Source : communiqué officiel d'OVHcloud.
3. L'isolement réseau
Le serveur fonctionne. Les disques sont intacts. Le processeur traite les requêtes.
Pourtant, en raison d'une erreur de routage, d'une coupure de fibre dorsale ou d'une panne réseau majeure, les utilisateurs ne parviennent plus à s'y connecter.
Pour l'internaute, la différence est inexistante.
Un serveur opérationnel mais injoignable et un serveur détruit ont exactement le même résultat : le site ne s'ouvre pas.
4. L'erreur humaine
Le scénario le plus frustrant n'est parfois lié ni au fournisseur, ni aux pirates informatiques.
L'administrateur commet une erreur de commande. L'application supprime des données. Une mise à jour corrompt la structure de la base. Une mauvaise migration détruit une table essentielle.
Et c'est là qu'apparaît un autre piège.
Le serveur de secours risque de dupliquer sagement l'erreur du serveur principal.
Car un mécanisme de réplication est incapable de faire la différence entre une modification légitime et une commande catastrophique.
Trois systèmes de protection à ne pas confondre
On entend souvent : « Nous avons une sauvegarde, nous sommes donc protégés ».
Ou encore : « Nous avons deux serveurs, il ne peut rien nous arriver ».
Ces deux affirmations sont incomplètes.
Mécanisme | Fonction | Ce qu'il ne garantit pas
Backup | Restauration des données perdues ou endommagées | Un redémarrage instantané du site
Replication | Maintien d'une copie actualisée de la base sur un autre nœud | Une protection contre la suppression accidentelle de données
Failover | Bascule du service vers un nœud de secours | La conservation de chaque transaction sans configuration spécifique
Provider independence | Possibilité de poursuivre l'activité hors d'une seule plateforme | L'indépendance vis-à-vis du DNS, du domaine et des comptes partagés
Une véritable résilience face aux catastrophes n'existe que lorsque ces mécanismes se complètent.
Deux chiffres pour amorcer la conception
RPO (Recovery Point Objective) — le volume de perte de données tolérable, généralement exprimé en temps.
Par exemple, un RPO de 15 minutes signifie qu'après un incident, le système doit pouvoir redécouvrir ses données avec une perte maximale équivalant aux 15 dernières minutes.
RTO (Recovery Time Objective) — le temps d'interruption maximal toléré.
Par exemple, un RTO de deux heures signifie que le service doit à nouveau être capable de répondre aux utilisateurs dans les deux heures suivant la panne.
Il ne s'agit pas d'arguments marketing pour un serveur, mais d'exigences métier.
Pour un blog d'information, perdre quelques minutes de publications n'est qu'un désagrément.
Pour un système gérant des paiements, des soldes et des opérations financières, la perte d'une seule transaction confirmée peut constituer un incident grave.
Il est impossible de concevoir une stratégie de redondance sans avoir défini au préalable ce qui doit être sauvé et avec quelle rapidité.
L'architecture de survie : trois lignes de défense indépendantes
Examinons un modèle pratique destiné à un projet web en phase de croissance.
Il ne nécessite pas de construire immédiatement son propre centre de données, mais impose de répartir l'infrastructure par zones de responsabilité.
Ligne A : L'environnement principal (Production)
C'est ici que s'exécutent :
- Nginx et les applications.
- La base PostgreSQL principale.
- Les gestionnaires de tâches en arrière-plan.
- Les files d'attente.
- Le stockage opérationnel des fichiers.
Il s'agit de l'infrastructure de production classique.
Son rôle est de servir les utilisateurs rapidement et de manière stable.
Ligne B : L'environnement de secours (Standby)
Il est hébergé chez un autre fournisseur, de préférence doté de dépendances réseau et administratives distinctes.
S'y trouvent préparés à l'avance :
- Un environnement applicatif compatible.
- Des images de conteneurs ou des builds reproductibles.
- Une base de données PostgreSQL de secours en mode Standby.
- L'accès aux secrets nécessaires via un mécanisme sécurisé.
- Une procédure de reprise de charge.
En fonctionnement normal, cet environnement ne sert pratiquement pas les utilisateurs.
Mais il doit être en mesure de remplacer l'environnement principal à tout moment.
Ligne C : L'archive indépendante
Ce troisième environnement ne participe pas au fonctionnement quotidien du site.
Son rôle est de survivre à la perte des deux serveurs, à une erreur d'administration ou à la compromission de l'infrastructure de production.
Il contient :
- Des sauvegardes complètes et incrémentielles.
- Des archives WAL permettant de restaurer PostgreSQL à un instant précis (Point-in-Time Recovery).
- Les fichiers des utilisateurs.
- Des copies des configurations et des manifests d'infrastructure.
- Les éléments chiffrés indispensables à la restauration.
Pour ce niveau, des stockages objets prenant en charge les archives immuables (comme Backblaze B2 ou des services compatibles S3) sont tout indiqués.
Schéma global
Utilisateurs → DNS / routeur de périphérie → Environnement principal
En cas de panne avérée :
Utilisateurs → Environnement de secours
Entre les environnements principal et de secours :
Canal sécurisé → Réplication WAL PostgreSQL → Contrôle de l'état de la réplique
Indépendamment des deux :
Dépôt de sauvegarde → Stockage objet sécurisé → Capacité de restauration à partir de zéro
Et de manière isolée :
Registraire de domaine + accès d'urgence + secrets de secours + documentation de restauration
Cette dernière ligne est tout aussi importante que les trois premières.
Car des serveurs peuvent être physiquement indépendants tout en restant tributaires d'une seule et même personne, d'un seul numéro de téléphone ou d'un unique compte administrateur.
PostgreSQL : pourquoi une seconde base de données ne garantit pas une perte de données nulle
PostgreSQL utilise un mécanisme de journalisation préalable appelé Write-Ahead Logging (WAL).
Avant qu'une modification des données ne soit définitivement validée, les informations la concernant sont inscrites dans un journal.
Ces journaux peuvent être transmis à un serveur de secours. C'est le principe de la réplication en continu (Streaming Replication).
Mais il y a ici une nuance critique.
Par défaut, la réplication en continu est asynchrone.
Le serveur principal peut confirmer une opération à l'utilisateur avant même que l'enregistrement correspondant ne soit parvenu au nœud de secours.
Si l'environnement principal disparaît à cet instant précis, une partie des modifications validées risque d'être perdue.
La réplication synchrone permet d'accroître les garanties d'intégrité, puisque la validation d'une transaction dépend de la réception d'accusés de réception de la part du serveur de secours.
Le prix à payer : une latence accrue et le risque d'un blocage des écritures si la réplication requise devient inaccessible.
Le choix du mode doit donc se faire en fonction du RPO, de la latence réseau et de la nature des opérations.
Documentation officielle : PostgreSQL 16, Streaming and Synchronous Replication.
Le piège des deux maîtres (Split-Brain)
Il existe une erreur encore plus dangereuse.
Imaginons que le serveur principal ne soit pas détruit, mais qu'il perde sa liaison avec le serveur de secours.
Le système de surveillance le considère comme mort et promeut automatiquement le serveur de secours (Standby) au rang de serveur principal (Primary).
Désormais, les deux bases de données acceptent de nouvelles écritures de manière indépendante.
Un utilisateur se connecte au premier serveur, un autre au second.
L'historique des données diverge.
C'est ce qu'on appelle le split-brain (cerveau divisé).
Pour l'éviter, il ne suffit pas de vérifier l'accessibilité : il faut un mécanisme de fencing (isolation), qui garantit l'exclusion formelle de l'ancien serveur Primary du service avant l'activation du nouveau.
La bascule automatique doit tenir compte d'une décision prise de manière concertée, de l'état de la réplication et du retour sécurisé du nœud réparé.
Une simple commande pg_ctl promote ne résout pas ces problèmes à elle seule.
Documentation : PostgreSQL, Failover.
Il est parfois plus prudent de consacrer quelques minutes à une bascule manuelle contrôlée que de créer automatiquement deux bases de données conflictuelles en cinq secondes.
Sauvegardes : l'archive qui ne doit pas périr avec le serveur
Imaginons qu'un attaquant obtienne un accès administrateur complet à la machine principale.
Il supprime la base de données de production.
Puis il repère le répertoire des sauvegardes et l'efface également.
Si tout était stocké sur le même serveur, il n'y avait, dans les faits, aucune sauvegarde.
Pour se prémunir contre cela, il est utile d'appliquer la règle 3-2-1-1-0 :
- 3 copies des données, en comptant l'originale.
- 2 types de supports différents ou de systèmes de stockage indépendants.
- 1 copie située hors du site principal.
- 1 copie immuable ou physiquement déconnectée.
- 0 erreur de restauration non détectée lors des tests.
Il s'agit d'un repère pratique et non d'une garantie universelle.
Pour PostgreSQL, l'un des outils adaptés est pgBackRest. Il gère les sauvegardes complètes, différentielles et incrémentielles, l'archivage WAL ainsi que la restauration à un moment précis (Point-in-Time Recovery).
Attention : une sauvegarde incrémentielle dépend des sauvegardes précédentes de la chaîne. Conserver uniquement la dernière archive incrémentielle ne suffit pas.
Documentation : pgBackRest User Guide.
À quoi sert l'Object Lock ?
Des services de stockage tels que Backblaze B2 prennent en charge des modes de protection des objets contre la suppression et l'écrasement.
En mode Governance (Gouvernance), certaines actions privilégiées peuvent contourner les restrictions.
En mode Compliance (Conformité), un objet protégé ne peut être ni supprimé ni voir sa durée de rétention raccourcie avant l'expiration de la période définie, et ce, même en disposant des privilèges administrateur les plus élevés.
Cependant, le simple fait d'activer l'Object Lock ne garantit pas que tous les fichiers versés ont reçu la période de conservation adéquate. La politique doit être correctement configurée et testée.
Documentation : Backblaze B2 Object Lock.
Et une règle d'or :
Les clés de déchiffrement des sauvegardes ne doivent pas être conservées exclusivement sur le serveur que ces sauvegardes sont censées secourir.
Le test suprême
À intervalles réguliers, il est impératif de déployer une machine vierge et d'y restaurer le système à partir des archives.
Il ne s'agit pas simplement de vérifier que le fichier existe.
Il faut s'assurer que PostgreSQL démarre, que les tables sont accessibles, que l'application s'y connecte, que les fichiers des utilisateurs sont présents et que les opérations de contrôle s'exécutent correctement.
Une sauvegarde ne devient une protection avérée qu'après une restauration réussie.
DNS et CDN : le dernier verrou de la porte d'entrée
Même deux serveurs totalement indépendants ne sauveront pas votre projet si les utilisateurs ignorent où se connecter.
Le routage fait donc partie intégrante du plan de reprise.
Cloudflare Load Balancing, par exemple, prend en charge le basculement Actif-Passif (Active-Passive Failover) : lorsqu'un pool principal est déclaré défectueux, le trafic est redirigé vers le pool de secours.
Source : Cloudflare Load Balancing, Active-Passive Failover.
Cependant, le délai de bascule dépend des intervalles de surveillance, des seuils de panne, de l'état de l'application et de l'infrastructure réseau.
Il serait imprudent de promettre à tous les projets des délais garantis de 10 ou 15 secondes.
Il faut également anticiper le scénario dans lequel le fournisseur de périphérie (CDN) lui-même deviendrait inaccessible.
Pour cela, on prépare en amont une procédure d'urgence de modification des DNS ou de contournement du CDN, l'accès au registraire de noms de domaine, des certificats TLS adaptés et un chemin réseau alternatif.
De plus, cette procédure doit être testée au préalable. Modifier les DNS en pleine situation de crise peut prendre du temps et ne garantit pas, à elle seule, un rétablissement immédiat pour tous les clients.
L'indépendance vis-à-vis d'un serveur ne sert à rien si l'adresse de ce serveur ne peut pas être modifiée sans l'autorisation d'un tiers.
Stateless et Stateful : ce que l'on peut recréer et ce qu'il ne faut surtout pas perdre
Il existe un principe qui simplifie considérablement la reprise après sinistre.
Tout ce qui peut être reconstitué à partir du code source et de la configuration doit être strictement séparé des données utilisateur uniques.
Stateless : les applications reproductibles
Les interfaces front-end, les API, certains gestionnaires de tâches en arrière-plan et des processus utilitaires peuvent être empaquetés dans des conteneurs.
Mais un conteneur ne garantit pas l'indépendance à lui seul.
Il faut disposer des sources, des fichiers de build, des dépendances et de l'accès aux images, ou de la capacité de les recompiler.
Le temps de démarrage dépend de la taille de l'application, de l'infrastructure et de la disponibilité des dépendances. Le chiffre magique de « 30 secondes » n'existe pas.
Stateful : les données et l'historique
PostgreSQL, les fichiers téléchargés par les utilisateurs, les files d'attente persistantes, les états importants de Redis et toute autre donnée modifiable exigent une stratégie distincte.
Oublier les fichiers est particulièrement dangereux.
On peut réussir une restauration parfaite de la base de données et s'apercevoir que les photos, les documents et les pièces jointes des messages sont restés sur le disque détruit.
Par conséquent, le plan de reprise doit couvrir l'ensemble de l'historique utilisateur et pas seulement les tables PostgreSQL.
Un problème spécifique : les tâches en arrière-plan
Après une bascule, le serveur de secours risque de relancer les gestionnaires de tâches.
Si une tâche procède à une mise à jour de solde, à l'envoi d'une notification ou à une transaction externe, une réexécution peut dupliquer l'opération.
C'est pourquoi les processus critiques doivent s'appuyer sur l'idempotence, des identifiants d'opérations uniques et une vérification des actions déjà accomplies.
La résilience face aux pannes ne concerne pas seulement le stockage des données, mais aussi la cohérence de la logique métier après un incident.
Combien coûte l'indépendance et quand est-elle réellement nécessaire ?
C'est ici qu'intervient une discussion que les vendeurs de services cloud apprécient rarement.
La redondance a un coût.
Un second environnement consomme des ressources. La réplication génère du trafic. Les archives occupent de l'espace. La surveillance demande du paramétrage. Les tests de restauration réguliers prennent du temps.
Cependant, la solution la plus onéreuse n'est pas nécessairement la bonne.
Niveau 1 : Restauration vérifiable
Convient aux petits sites, aux blogs, aux catalogues et aux projets en phase de démarrage.
Schéma minimal :
- Un serveur principal unique.
- Un stockage de sauvegarde indépendant.
- Une sauvegarde automatisée de la base et des fichiers.
- Des configurations et des codes sources sauvegardés.
- Une vérification régulière de la restauration.
- Une procédure de migration documentée.
Objectif principal : pouvoir restaurer le projet de manière garantie après la perte totale du serveur, dans le respect des RTO et RPO définis.
Niveau 2 : Environnement de secours préparé
Convient aux services en croissance disposant d'un public fidèle et d'opérations sensibles aux interruptions.
Éléments ajoutés :
- Un second fournisseur.
- Une application préparée.
- Une réplique PostgreSQL.
- Une surveillance de la latence de réplication.
- Un scénario de bascule manuelle testé.
- Un plan de retour vers l'environnement principal.
Il s'agit déjà d'une architecture de haute disponibilité sérieuse, sans qu'il soit impératif de mettre en place une automatisation complexe.
Niveau 3 : Bascule automatique gérée
Convient aux systèmes où le temps d'indisponibilité coûte cher et où les exigences de RTO/RPO justifient pleinement les dépenses supplémentaires.
S'y ajoutent :
- Un basculement automatique (failover).
- Un mécanisme robuste de prise de décision pour la promotion du Primary.
- Du fencing et une protection contre le split-brain.
- Des vérifications de la santé de l'application, et pas seulement de l'accessibilité d'un port.
- Un contrôle de la réexécution des opérations.
- Des exercices de crise réguliers.
- De l'observabilité et des alertes.
Il est inutile d'acheter l'architecture d'une grande banque pour un site comptant quelques dizaines de visiteurs. Mais il n'est plus possible non plus de confier l'historique d'une entreprise en croissance à un seul et unique disque.
Le cloud gratuit : un bon laboratoire, une mauvaise garantie éternelle
Pour expérimenter la redondance, il est possible de s'appuyer sur des offres d'essai cloud.
Par exemple, AWS propose un niveau gratuit (Free Tier) aux nouveaux clients.
Mais un changement notable a eu lieu.
Depuis juillet 2025, AWS a introduit un nouveau modèle : jusqu'à 200 dollars de crédits pour les nouveaux clients, dont une partie est allouée à l'inscription, tandis que le reste dépend du respect de conditions d'utilisation.
Le forfait gratuit est valable jusqu'à six mois ou jusqu'à épuisement des crédits, selon la première de ces éventualités.
Cela diffère des offres précédentes, où certaines ressources étaient fournies dans le cadre d'une période de 12 mois.
Source : AWS Free Tier FAQ.
Ce type de compte s'avère utile pour tester :
- Le déploiement d'une application de secours.
- La configuration de WireGuard.
- Des expérimentations avec PostgreSQL Standby.
- La vérification de la migration vers un autre environnement.
- La mesure du temps de restauration.
Néanmoins, avant toute utilisation, il convient de vérifier les limites des ressources concernées, les conditions de passage à un tarif payant, le stockage des données, le trafic réseau et le coût d'exploitation une fois la période d'essai achevée.
Un serveur gratuit est idéal pour répéter une catastrophe. Il ne doit pas devenir votre unique espoir de sauver votre entreprise.
Règlement d'ingénierie : dix vérifications avant la catastrophe
Le propriétaire d'un projet doit être en mesure de répondre à dix questions.
- Où se trouvent physiquement les données principales ?
- Où est située la sauvegarde indépendante ?
- Est-il possible de restaurer le projet sans accéder à l'hébergement principal ?
- Quels sont les RPO et RTO acceptables ?
- Qui prend la décision de basculer, et de quelle manière ?
- Qu'est-ce qui empêche le fonctionnement simultané de deux bases principales ?
- Comment restaure-t-on les photos, documents, files d'attente et fichiers téléchargés par les utilisateurs ?
- Que deviennent les paiements et les tâches de fond après une bascule ?
- Conserve-t-on le contrôle du domaine, des DNS et des secrets en cas de perte d'un compte ?
- À quand remonte la dernière restauration complète sur un serveur vierge ?
Si plusieurs de ces questions restent sans réponse, cela ne signifie pas nécessairement que le projet est au bord du gouffre.
Cela signifie simplement que ses réelles limites de résistance sont encore inconnues.
Et c'est précisément par là qu'il faut commencer.
La souveraineté ne commence pas par l'achat d'un serveur
Il est tentant de régler le problème par un investissement d'envergure.
S'offrir un serveur dédié puissant. Installer les meilleurs disques. Ajouter de la mémoire vive. Configurer le chiffrement matériel. Déployer son propre système de surveillance.
Tout cela peut s'avérer utile.
Cependant, même le serveur le plus cher du monde reste un point de défaillance unique s'il n'y a rien pour le remplacer.
À l'inverse, une infrastructure comparativement modeste peut se révéler d'une robustesse surprenante si son propriétaire a préparé en amont des archives indépendantes, un environnement reproductible et une procédure de restauration testée.
Le cloud n'est pas un ennemi. Le serveur dédié n'est pas un sauveur. Le second fournisseur n'est pas une assurance magique.
La question est de savoir qui détient le contrôle sur la poursuite de l'activité.
Lorsqu'un projet ne peut être restauré que par l'intermédiaire du support d'un unique fournisseur, son existence dépend d'une décision extérieure.
Lorsqu'un propriétaire est capable de le redéployer sur un environnement indépendant, la donne change.
Il n'attend plus que quelqu'un lui rende son unique clé.
Il possède sa propre porte.
La véritable indépendance numérique ne commence pas lorsque l'on possède deux serveurs. Elle commence lorsque l'on a prouvé que l'on est capable de poursuivre son activité sans le premier.
Liv et Jora. Article technique et analytique conjoint consacré à la résilience face aux pannes, à l'indépendance numérique et à l'architecture de survie des projets internet.
Cet article expose des principes architecturaux. Les paramètres précis de réplication, de sauvegarde et de bascule doivent être sélectionnés et testés individuellement pour chaque infrastructure.