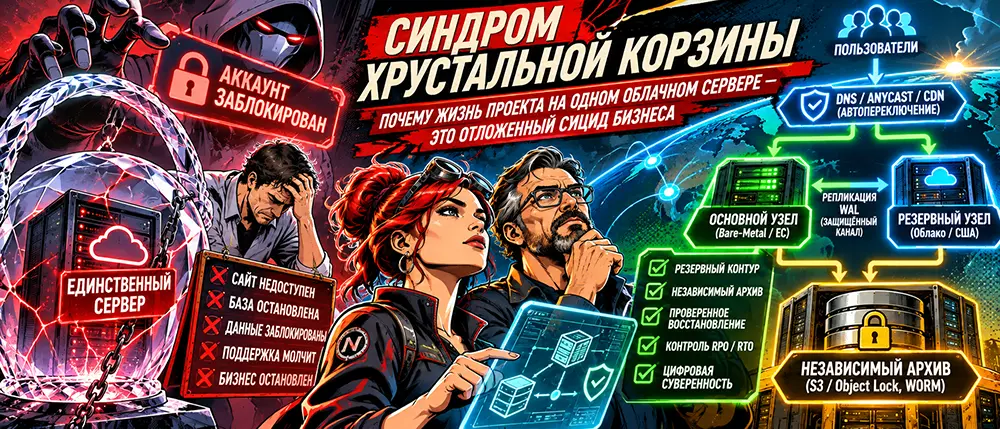
Как одна блокировка способна остановить целую компанию, почему второй сервер ещё не означает безопасность и что на самом деле нужно для цифровой независимости.
Совместный материал Лив и Жоры
Ресторан, у которого отобрали дверь
Представь, что ты открыл ресторан в огромном торговом центре.
Мраморный пол, панорамные окна, красивая вывеска. По вечерам все столики заняты. Поставщики привозят продукты, бухгалтерия считает выручку, повара работают без остановки.
Бизнес растёт.
Но есть одна особенность, которую ты не замечаешь.
Кухня, склад, бухгалтерия, кассовый сервер, сейф и электрический щит находятся в одной подсобке. А единственный ключ от неё принадлежит администрации торгового центра.
Однажды утром корпоративная система безопасности обнаруживает несоответствие в платёжных документах арендатора.
Срабатывает автоматическая блокировка.
Роллеты опускаются. Повара не могут попасть на кухню. Посетители стоят перед закрытым входом. Поставщики разворачивают машины.
Ты звонишь в поддержку.
Робот сообщает, что обращение зарегистрировано.
Через час он повторяет то же самое.
Через сутки тоже.
Твой бизнес никто не взламывал. Не было пожара, рейдерского захвата или банкротства.
Он просто перестал существовать для клиентов, потому что единственная дверь находилась под чужим контролем.
Добро пожаловать в архитектуру современного цифрового бизнеса.
Один сервер. Один аккаунт. Одна точка отказа
Небольшой интернет-проект обычно начинается одинаково.
Разработчик арендует виртуальный сервер. Устанавливает Linux, PostgreSQL, Redis, Nginx. Разворачивает приложение, подключает домен, настраивает SSL и запускает сервис.
Всё работает.
Через несколько месяцев появляются пользователи, публикации, заказы, платежи и собственная история проекта.
Но архитектура остаётся прежней.
На одной машине могут одновременно находиться:
- Приложение и административная панель.
- Основная база данных.
- Пользовательские фотографии и документы.
- Очереди фоновых заданий.
- Секреты интеграций и ключи API.
- Локальные резервные копии.
Пока сервер исправен, такая система кажется надёжной.
Проблема обнаруживается в момент, когда он становится недоступен.
В инженерии это называется Single Point of Failure (SPOF), единая точка отказа.
Но сервером дело не ограничивается.
Единственной точкой отказа может оказаться аккаунт облачного провайдера, регистратор домена, DNS-платформа, платёжный профиль или хранилище резервных копий.
Если отказ одного элемента способен остановить всю систему, значит, независимость этой системы существует только на бумаге.
Инженерная проверка
Представь, что завтра твой основной хостинг полностью исчез. Вместе с панелью управления, SSH-доступом и возможностью скачать диск.
Сколько времени потребуется, чтобы восстановить проект у другого провайдера?
Если ответа нет, у тебя пока не план восстановления, а надежда на удачу.
Анатомия катастрофы: четыре способа потерять работающий бизнес
1. Административная блокировка
Облачные платформы предоставляют мощную инфраструктуру, но доступ к ней регулируется условиями обслуживания, биллингом и процедурами безопасности.
Например, Google Cloud официально предупреждает: при приостановке Cloud Billing account связанные ресурсы могут быть остановлены. Среди причин возможны проблемы с оплатой, подозрения на мошенничество и нарушения условий использования.
Это не означает, что любая отклонённая банковская транзакция немедленно выключит сервер. Но такая зависимость действительно существует.
И если все проекты находятся под одним платёжным аккаунтом, проблема может затронуть их одновременно.
Источник: Google Cloud, Project Suspension Guidelines.
2. Физическая авария
10 марта 2021 года в Страсбурге произошёл пожар в дата-центре OVHcloud SBG2.
Здание было практически уничтожено. Часть соседнего SBG1 также пострадала. Оборудование на других площадках комплекса пришлось временно отключить.
Это реальная история, а не гипотетический сценарий.
Сервер может иметь прекрасные показатели доступности, исправную операционную систему и защищённую базу данных. Но ни один программный механизм не спасёт его от уничтожения вместе со зданием.
Источник: официальное сообщение OVHcloud.
3. Сетевая изоляция
Сервер работает. Диски исправны. Процессор обрабатывает запросы.
Но из-за ошибки маршрутизации, повреждения магистрального канала или крупного сетевого сбоя пользователи не могут к нему подключиться.
Для посетителя разницы нет.
Недоступный исправный сервер и уничтоженный сервер выглядят одинаково: сайт не открывается.
4. Ошибка самого владельца
Самый неприятный сценарий иногда не связан ни с провайдером, ни с хакерами.
Администратор ошибается в команде. Приложение удаляет данные. Обновление повреждает структуру базы. Неверная миграция уничтожает важную таблицу.
И здесь обнаруживается другая ловушка.
Резервный сервер может послушно повторить ошибку основного.
Потому что репликация не умеет отличать законное изменение от катастрофической команды.
Три системы защиты, которые нельзя путать
Часто можно услышать: «У нас есть резервная копия, значит, мы защищены».
Или: «У нас два сервера, значит, ничего не случится».
Оба утверждения неполные.
МеханизмНазначениеЧего не гарантируетBackupВосстановление утраченных или повреждённых данныхМгновенного запуска сайтаReplicationПоддержание актуальной копии базы на другом узлеЗащиты от ошибочного удаления данныхFailoverПереключение обслуживания на резервный узелСохранения каждой транзакции без специальной настройкиProvider independenceВозможность продолжить работу вне одной площадкиНезависимости от DNS, домена и общих аккаунтов
Настоящая катастрофоустойчивость возникает только тогда, когда эти механизмы дополняют друг друга.
Два числа, с которых начинается проектирование
RPO (Recovery Point Objective) - допустимый объём потери данных, обычно выраженный временем.
Например, RPO в 15 минут означает, что после аварии система должна восстанавливаться с потерей данных не более чем за последние 15 минут.
RTO (Recovery Time Objective) - максимально допустимое время восстановления работы.
Например, RTO в два часа означает, что сервис должен снова обслуживать пользователей в течение двух часов после аварии.
Это не рекламные характеристики сервера. Это требования самого бизнеса.
Для информационного блога потеря нескольких минут публикаций может быть неприятностью.
Для системы с платежами, балансами и финансовыми операциями потеря подтверждённой транзакции уже способна стать серьёзным инцидентом.
Нельзя проектировать резервирование, пока не определено, что именно и насколько быстро требуется спасать.
Архитектура живучести: три независимых рубежа
Рассмотрим практическую модель для растущего интернет-проекта.
Она не требует сразу строить собственный дата-центр. Но требует разделить инфраструктуру по зонам ответственности.
Рубеж А. Основная площадка
Здесь работают:
- Nginx и приложения.
- Основная PostgreSQL.
- Фоновые обработчики.
- Очереди задач.
- Рабочие файловые хранилища.
Это обычная производственная инфраструктура.
Её задача - быстро и стабильно обслуживать пользователей.
Рубеж Б. Резервная площадка
Она размещается у другого провайдера, желательно с независимыми сетевыми и административными зависимостями.
На ней заранее подготовлены:
- Совместимое окружение приложений.
- Контейнерные образы или воспроизводимые сборки.
- Резервная PostgreSQL в режиме Standby.
- Доступ к необходимым секретам через защищённый механизм.
- Процедура принятия нагрузки.
В штатном режиме площадка может практически не обслуживать пользователей.
Но она должна быть способна заменить основную.
Рубеж В. Независимый архив
Третья площадка не участвует в обычной работе сайта.
Её задача - пережить потерю обоих серверов, ошибку администратора и компрометацию производственной инфраструктуры.
Здесь находятся:
- Полные и инкрементальные резервные копии.
- Архивы WAL для восстановления PostgreSQL на нужный момент времени.
- Пользовательские файлы.
- Копии конфигураций и инфраструктурных манифестов.
- Зашифрованные материалы, необходимые для восстановления.
Для такого рубежа подходят объектные хранилища с поддержкой неизменяемых архивов, например Backblaze B2 или совместимые S3-сервисы.
Общая схема
Пользователи → DNS / пограничный маршрутизатор → основная площадка
При подтверждённом отказе:
Пользователи → резервная площадка
Между основной и резервной площадками:
Защищённый канал → PostgreSQL WAL Replication → контроль состояния реплики
Независимо от обеих:
Backup Repository → защищённое объектное хранилище → возможность восстановления с нуля
И отдельно:
Регистратор домена + аварийный доступ + резервные секреты + документация восстановления
Последняя строка не менее важна, чем первые три.
Потому что серверы могут быть независимыми физически, но оставаться зависимыми от одного человека, одного телефона или одной административной учётной записи.
PostgreSQL: почему вторая база ещё не означает нулевую потерю данных
PostgreSQL использует механизм Write-Ahead Logging (WAL).
Прежде чем изменение данных окончательно фиксируется, информация о нём записывается в журнал.
Эти журналы можно передавать на резервный сервер. Так работает потоковая репликация.
Но здесь есть критический нюанс.
По умолчанию Streaming Replication асинхронна.
Основной сервер может подтвердить пользователю операцию до того, как соответствующая запись достигнет резервного узла.
Если в этот момент основная площадка исчезнет, часть подтверждённых изменений может быть потеряна.
Синхронная репликация позволяет повысить гарантии сохранности, поскольку подтверждение транзакции зависит от получения необходимых подтверждений резервным сервером.
Цена - дополнительная задержка и риск остановки записи при недоступности требуемой реплики.
Поэтому выбирать режим необходимо исходя из RPO, сетевой задержки и характера операций.
Официальная документация: PostgreSQL 16, Streaming and Synchronous Replication.
Ловушка двух хозяев
Есть ещё более опасная ошибка.
Представим, что основной сервер не погиб, а потерял связь с резервным.
Система мониторинга считает его мёртвым и автоматически переводит Standby в Primary.
Теперь обе базы могут принимать новые записи независимо.
Один пользователь попадает на первый сервер, другой - на второй.
История данных расходится.
Это называется split-brain.
Для предотвращения нужны не только проверки доступности, но и механизм fencing: гарантированное исключение старого Primary из обслуживания до включения нового.
Автоматическое переключение должно учитывать согласованное принятие решения, состояние репликации и безопасное возвращение восстановленного узла.
Простая команда pg_ctl promote сама по себе этих проблем не решает.
Документация: PostgreSQL, Failover.
Иногда безопаснее потратить несколько минут на контролируемое ручное переключение, чем автоматически создать две конфликтующие базы за пять секунд.
Резервные копии: архив, который нельзя уничтожить вместе с сервером
Допустим, злоумышленник получил полный административный доступ к основной машине.
Он удаляет рабочую базу.
Затем находит каталог резервных копий и удаляет его тоже.
Если всё хранилось на одном сервере, резервирования фактически не было.
Для защиты полезно применять принцип 3-2-1-1-0:
- 3 копии данных, включая рабочую.
- 2 разных типа носителей или независимых систем хранения.
- 1 копия за пределами основной площадки.
- 1 неизменяемая либо физически отключённая копия.
- 0 необнаруженных ошибок восстановления после проверок.
Это практический ориентир, а не универсальная гарантия.
Для PostgreSQL одним из подходящих инструментов является pgBackRest. Он поддерживает полные, дифференциальные и инкрементальные копии, архивирование WAL и восстановление на определённый момент времени (Point-in-Time Recovery).
Важно: инкрементальная копия зависит от предыдущих копий в цепочке. Сохранить только последний инкрементальный архив недостаточно.
Документация: pgBackRest User Guide.
Зачем нужен Object Lock
Хранилища вроде Backblaze B2 поддерживают режимы защиты объектов от удаления и перезаписи.
В режиме Governance определённые привилегированные действия могут обходить ограничения.
В режиме Compliance защищённый объект нельзя удалить или сократить срок его удержания до завершения установленного периода, даже обладая высокими административными правами.
Но сам факт включения Object Lock ещё не означает, что все загруженные файлы получили нужный срок хранения. Политику необходимо правильно настроить и проверить.
Документация: Backblaze B2 Object Lock.
И ещё одно правило:
Ключи расшифровки резервных копий нельзя хранить исключительно на сервере, потерю которого эти копии должны пережить.
Главный тест
Раз в установленный период нужно развернуть чистую машину и восстановить на ней систему из архива.
Не просто убедиться, что файл существует.
А проверить, что PostgreSQL запускается, таблицы доступны, приложение подключается, пользовательские файлы на месте и контрольные операции выполняются корректно.
Резервная копия становится доказанной защитой только после успешного восстановления.
DNS и CDN: последний замок на входной двери
Даже два полностью независимых сервера не спасут проект, если пользователи не могут узнать, куда подключаться.
Поэтому маршрутизация тоже входит в план восстановления.
Cloudflare Load Balancing, например, поддерживает Active-Passive Failover: при признании основного пула неисправным трафик переводится на резервный.
Источник: Cloudflare Load Balancing, Active-Passive Failover.
Однако время переключения зависит от интервалов мониторинга, порогов отказа, состояния приложения и сетевой инфраструктуры.
Обещать всем проектам гарантированные 10 или 15 секунд неправильно.
Необходимо также учитывать сценарий, при котором недоступен сам пограничный провайдер.
Для этого заранее готовят аварийную процедуру изменения DNS или обхода CDN, доступ к регистратору домена, подходящие TLS-сертификаты и альтернативный маршрут.
Причём процедура должна быть проверена заранее. Переключение DNS в момент аварии может занять время и само по себе не гарантирует немедленного восстановления всех клиентов.
Независимость от сервера бессмысленна, если адрес этого сервера невозможно изменить без разрешения третьей стороны.
Stateless и Stateful: что можно поднять заново, а что нельзя потерять
Есть принцип, который заметно упрощает аварийное восстановление.
Всё, что можно воспроизвести из исходного кода и конфигурации, должно быть максимально отделено от уникальных пользовательских данных.
Stateless: воспроизводимые приложения
Фронтенды, API, некоторые фоновые обработчики и служебные процессы можно упаковать в контейнеры.
Но контейнер сам по себе не гарантирует независимости.
Нужно иметь исходники, файлы сборки, зависимости и доступ к образам либо возможность собрать их заново.
Время запуска зависит от размера приложения, инфраструктуры и готовности зависимостей. Универсальных «30 секунд» не существует.
Stateful: данные и история
PostgreSQL, пользовательские загрузки, постоянные очереди, важные состояния Redis и другие изменяемые данные требуют отдельной стратегии.
Особенно опасно забыть про файлы.
Можно идеально восстановить базу данных, но обнаружить, что фотографии, документы и вложения сообщений остались на уничтоженном диске.
Поэтому план восстановления должен охватывать всю пользовательскую историю, а не только таблицы PostgreSQL.
Отдельная проблема: фоновые задания
После переключения резервный сервер может повторно запустить обработчики.
Если задание выполняет начисление баланса, отправку уведомления или внешнюю транзакцию, повторный запуск способен создать дубликат операции.
Поэтому критичные процессы должны использовать идемпотентность, уникальные идентификаторы операций и проверку уже выполненных действий.
Катастрофоустойчивость касается не только хранения данных, но и правильности бизнес-логики после аварии.
Сколько стоит независимость и когда она действительно нужна
Здесь начинается разговор, который редко любят продавцы облачных услуг.
Резервирование стоит денег.
Вторая площадка потребляет ресурсы. Репликация создаёт трафик. Архивы занимают место. Мониторинг требует настройки. Регулярные тесты восстановления отнимают время.
Но самое дорогое решение не обязательно самое правильное.
Уровень 1. Проверяемое восстановление
Подходит для небольших сайтов, блогов, каталогов и проектов на ранней стадии.
Минимальная схема:
- Один основной сервер.
- Независимое хранилище резервных копий.
- Автоматическое резервирование базы и файлов.
- Сохранённые конфигурации и исходники.
- Регулярная проверка восстановления.
- Документированная процедура переноса.
Главная цель: гарантированно восстановить проект после полной потери сервера в пределах установленного RTO и RPO.
Уровень 2. Подготовленная резервная площадка
Подходит для растущих сервисов с постоянной аудиторией и чувствительными к простою операциями.
Добавляются:
- Второй провайдер.
- Подготовленное приложение.
- Реплика PostgreSQL.
- Мониторинг задержки репликации.
- Проверенный сценарий ручного переключения.
- План возвращения на основную площадку.
Это уже серьёзная отказоустойчивая архитектура без обязательного внедрения сложной автоматизации.
Уровень 3. Управляемое автоматическое переключение
Подходит для систем, где простой дорого обходится и требования RTO/RPO действительно оправдывают дополнительные затраты.
Здесь появляются:
- Автоматический failover.
- Надёжный механизм принятия решения о смене Primary.
- Fencing и защита от split-brain.
- Проверки работоспособности приложения, а не только доступности порта.
- Контроль повторного выполнения операций.
- Регулярные аварийные учения.
- Наблюдаемость и оповещения.
Не нужно покупать архитектуру крупного банка для сайта с несколькими десятками посетителей. Но и хранить историю растущего бизнеса на единственном диске уже нельзя.
Бесплатное облако: хорошая лаборатория, плохая вечная гарантия
Для экспериментов с резервированием можно использовать пробные облачные программы.
Например, AWS предоставляет новым клиентам Free Tier.
Но здесь есть важное изменение.
С июля 2025 года AWS ввела новую модель: до 200 долларов кредитов для новых клиентов, из которых часть предоставляется при регистрации, а дополнительная часть зависит от выполнения условий программы.
Бесплатный план действует до шести месяцев либо до исчерпания кредитов, в зависимости от того, что наступит раньше.
Это отличается от прежних предложений, в которых отдельные ресурсы предоставлялись в рамках 12-месячного периода.
Источник: AWS Free Tier FAQ.
Такой аккаунт может быть полезен для тестирования:
- Развёртывания резервного приложения.
- Настройки WireGuard.
- Экспериментов с PostgreSQL Standby.
- Проверки переноса на другую площадку.
- Измерения времени восстановления.
Но перед использованием нужно проверить лимиты конкретных ресурсов, условия перехода на платный тариф, хранение данных, сетевой трафик и стоимость эксплуатации после завершения пробного периода.
Бесплатный сервер хорош для репетиции катастрофы. Он не должен становиться единственной надеждой на спасение бизнеса.
Инженерный регламент: десять проверок перед аварией
Владелец проекта должен иметь возможность ответить на десять вопросов.
- Где физически находятся основные данные?
- Где расположена независимая резервная копия?
- Можно ли восстановить проект без доступа к основному хостингу?
- Каковы допустимые RPO и RTO?
- Кто и как принимает решение о переключении?
- Что предотвращает одновременную работу двух основных баз?
- Как восстанавливаются фотографии, документы, очереди и пользовательские загрузки?
- Что произойдёт с платежами и фоновыми заданиями после переключения?
- Сохраняется ли управление доменом, DNS и секретами при потере одного аккаунта?
- Когда в последний раз проводилось полноценное восстановление на чистом сервере?
Если на несколько вопросов нет ответа, это не обязательно означает, что проект находится на грани катастрофы.
Это означает, что его реальные границы устойчивости пока неизвестны.
И именно с этого следует начинать работу.
Суверенность начинается не с покупки сервера
Существует соблазн решить проблему одним крупным приобретением.
Купить мощный dedicated server. Поставить лучшие накопители. Добавить оперативную память. Настроить аппаратное шифрование. Развернуть собственную систему мониторинга.
Всё это может быть полезно.
Но даже самый дорогой сервер остаётся единственной точкой отказа, если заменить его нечем.
И наоборот, сравнительно скромная инфраструктура может оказаться удивительно живучей, если её владелец заранее подготовил независимые архивы, воспроизводимое окружение и проверенную процедуру восстановления.
Облако не враг. Выделенный сервер не спаситель. Второй провайдер не волшебная страховка.
Вопрос в том, кто контролирует возможность продолжения работы.
Когда бизнес можно восстановить только через службу поддержки одного провайдера, его существование зависит от чужого решения.
Когда владелец способен развернуть его заново на независимой площадке, ситуация меняется.
Он больше не обязан ждать, пока кто-то вернёт ему единственный ключ.
У него есть собственная дверь.
Настоящая цифровая независимость начинается не тогда, когда у тебя два сервера. Она начинается тогда, когда ты доказал, что способен продолжить работу без первого.
Лив и Жора. Совместный инженерно-аналитический материал о катастрофоустойчивости, цифровой независимости и архитектуре выживания интернет-проектов.
Материал описывает архитектурные принципы. Конкретные параметры репликации, резервного копирования и переключения необходимо подбирать и проверять для каждой инфраструктуры отдельно.